
GPU AMD sur le réseau edge de YOM : une preuve de concept
Nous avons fait tourner notre réseau edge sur des GPU AMD dans une preuve de concept. Ce n'est pas encore en production. Voici ce que nous avons testé, ce que cela a demandé, et pourquoi un réseau ne devrait pas dépendre d'un seul fournisseur de GPU.
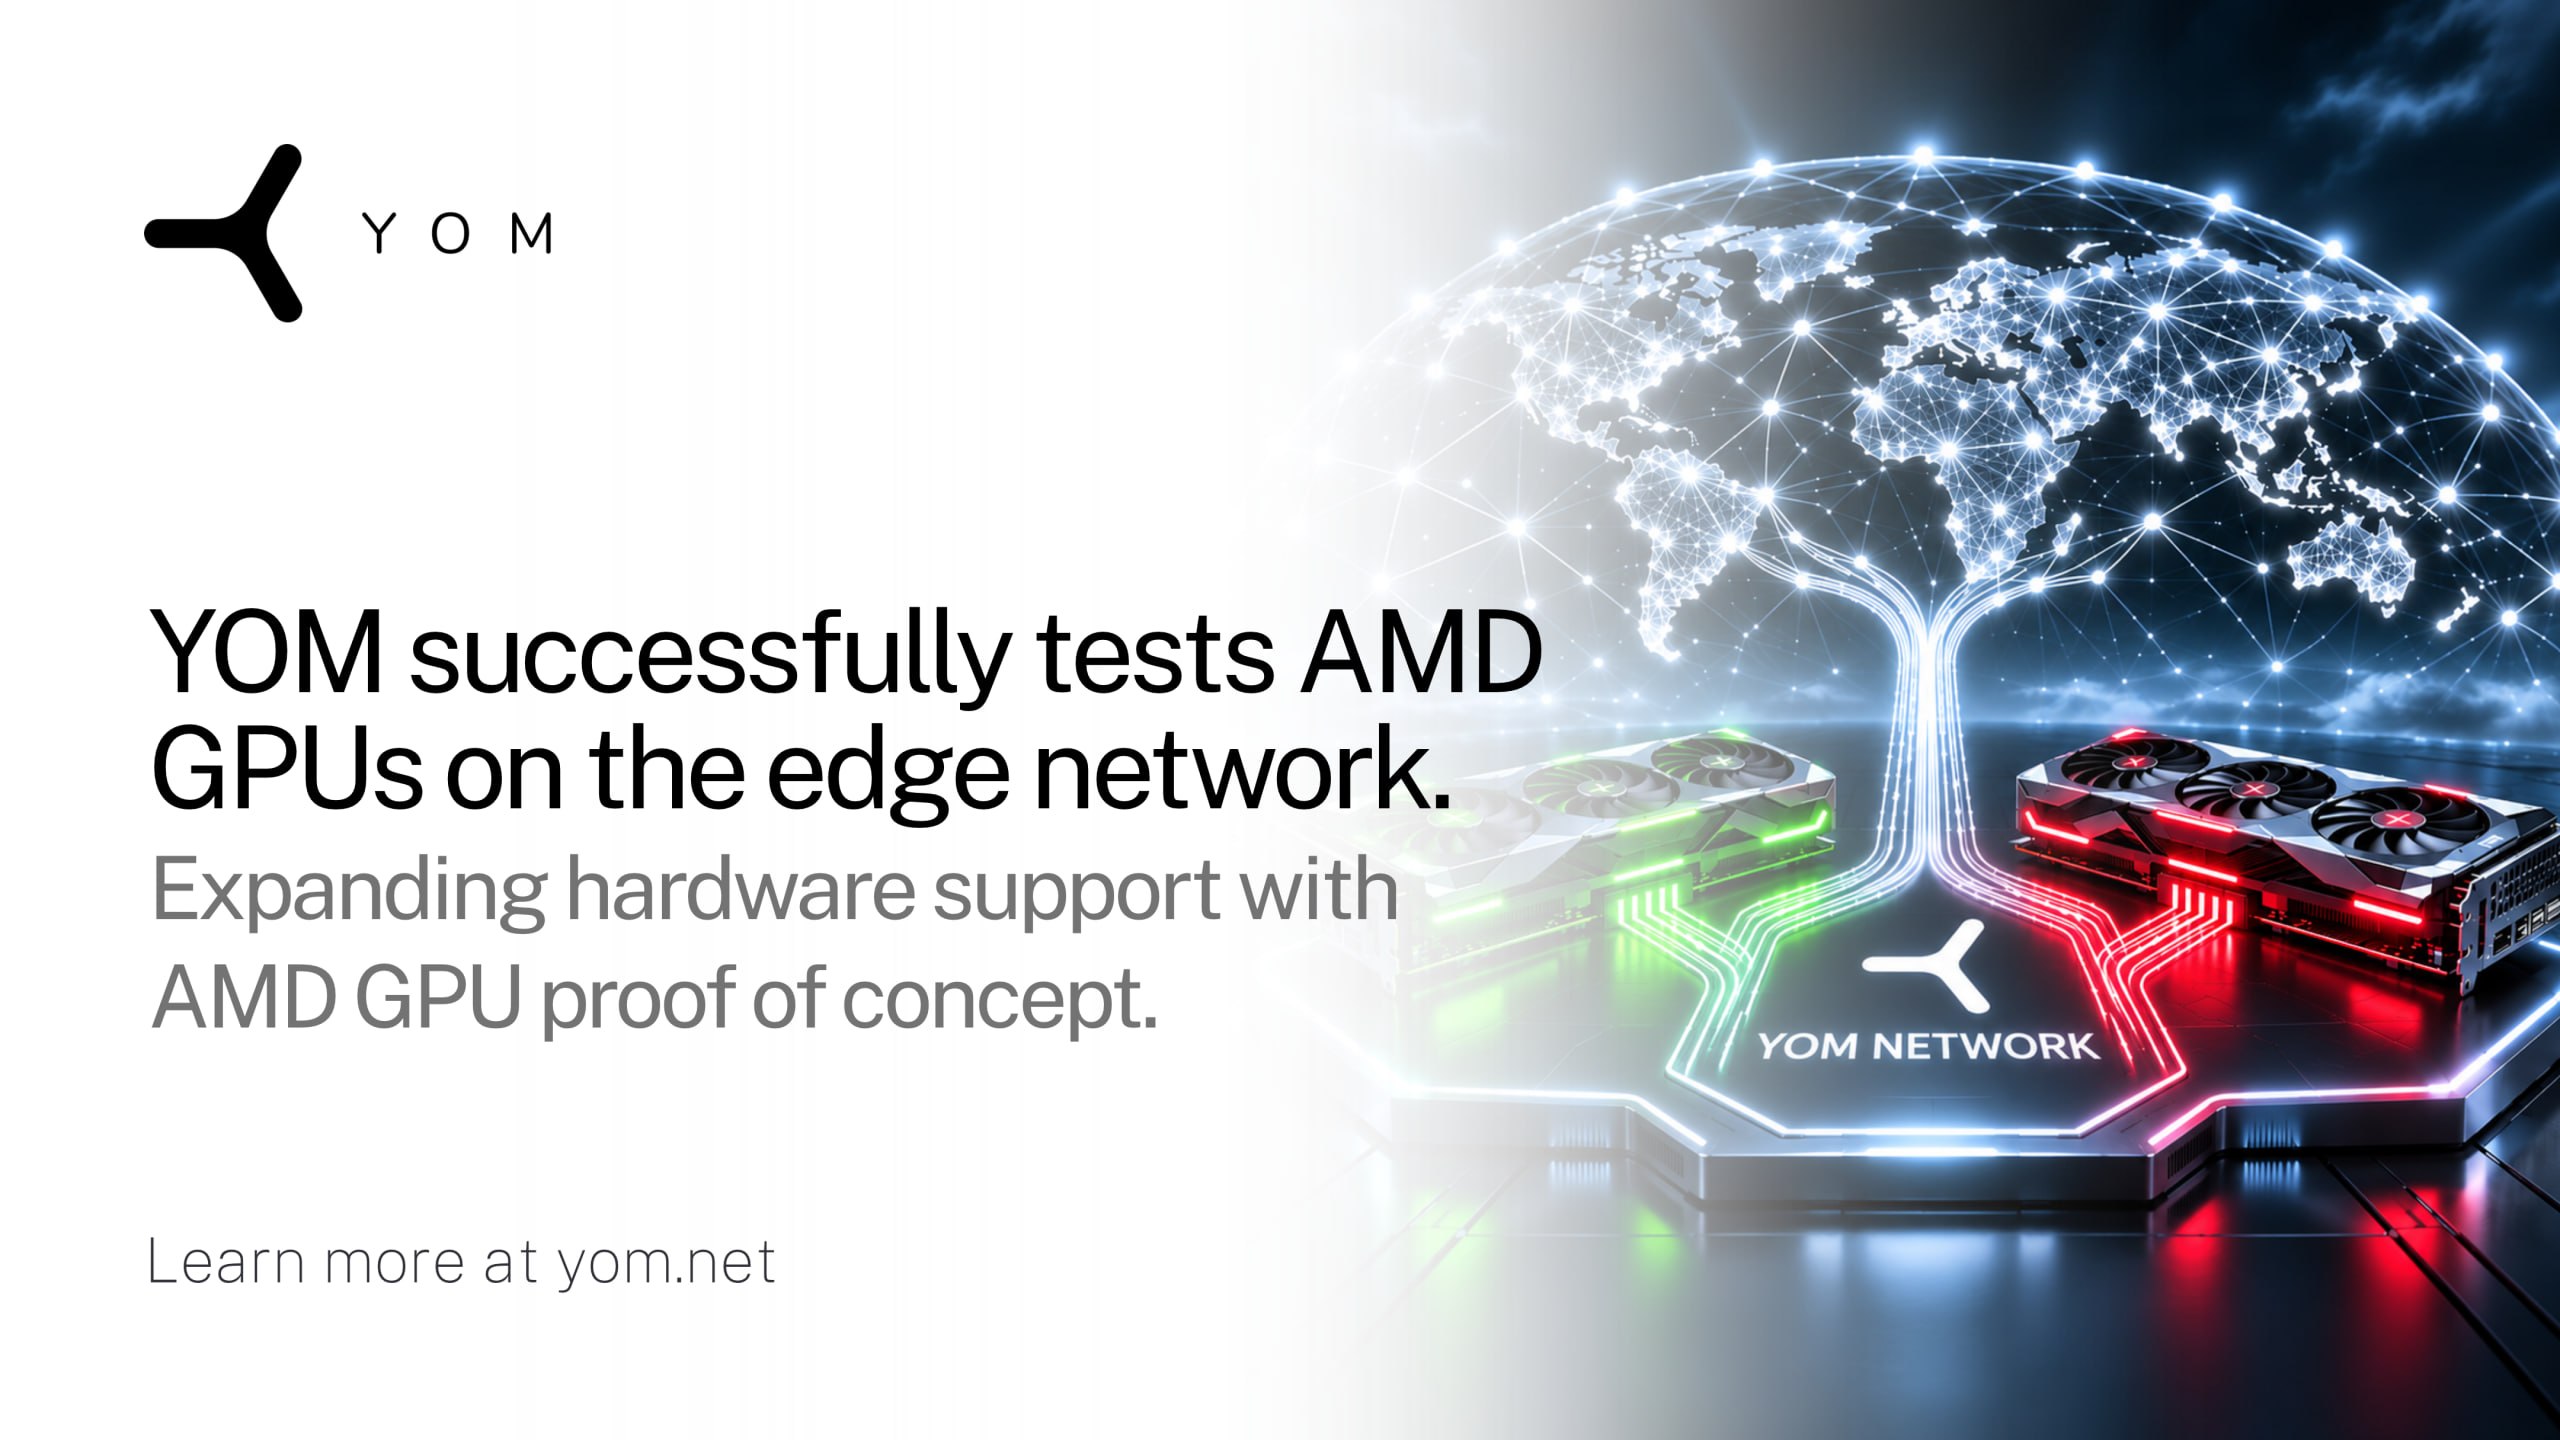
YOM a mené à bien une preuve de concept faisant tourner notre réseau edge sur des GPU AMD. Les GPU NVIDIA font tourner le réseau aujourd’hui, ils sont entièrement pris en charge, et cela ne change pas. Ce qui change, c’est qu’un PC ou un serveur équipé d’un GPU AMD pourra rejoindre le même réseau.
Cet article présente ce que nous avons fait, ce qui n’est pas encore en production, et pourquoi nous pensons que tout réseau d’infrastructure est plus solide lorsqu’il ne dépend pas d’un seul fournisseur.
Ce que nous avons fait
Des PC équipés de GPU AMD ont été testés et ont fonctionné avec le NANO. Nous avons aussi commencé à développer des serveurs pour les sites de tours télécoms, en complément du déploiement du NANO (ce qu’apportent les sites de tours).
Ce que ce n’est pas, pour l’instant
Une preuve de concept montre que quelque chose fonctionne. Ce n’est pas la même chose qu’être en service sur le réseau. Aujourd’hui, des hôtes et des joueurs ne tournent pas encore sur des nœuds AMD en production. Quand cela changera, nous le dirons ici et sur notre Discord, en précisant ce qui est pris en charge et ce qui ne l’est pas.
Ce que cela a demandé
Un GPU n’est pas une pièce interchangeable. Trois éléments diffèrent d’un fabricant à l’autre pour un réseau comme le nôtre :
- Les pilotes. Chaque fabricant a sa propre pile de pilotes, qui doit s’installer et se mettre à jour proprement sur la machine d’un hôte.
- L’encodage vidéo. Diffuser un jeu en streaming implique d’encoder la vidéo sur le GPU, et le matériel et le logiciel d’encodage sont différents sur les cartes de chaque fabricant.
- L’outillage de conteneurs. Chaque session tourne dans son propre conteneur, et donner à un conteneur l’accès au GPU fonctionne différemment pour chaque fabricant.
Nous construisons cela pour que le nœud détecte lui-même quel GPU il possède au démarrage. Les hôtes n’auront pas à choisir un fabricant ni à modifier un réglage. Les nœuds NVIDIA suivront le même chemin qu’ils ont toujours suivi.
Pourquoi nous le faisons
Le travail en temps réel exige un GPU proche de l’utilisateur ; nous plaçons donc des GPU à côté des utilisateurs, dans les foyers et sur les tours télécoms, plutôt que dans quelques grands sites. Répartir ainsi la charge évite aussi un point de pression unique sur un réseau électrique, une alimentation en eau ou une communauté locale.
L’approvisionnement en matériel fonctionne de la même façon. Un réseau qui dépend d’un seul fabricant pour chacun de ses GPU hérite de l’approvisionnement, des prix et des décisions de produit de ce fabricant. Un réseau qui peut en utiliser plusieurs a plus d’options les mauvais jours et plus de personnes qui peuvent le rejoindre.
Voilà l’argument en faveur de la prise en charge d’AMD, et c’est un argument d’ingénierie, pas une déclaration sur qui que ce soit d’autre. Nous voulons que des hôtes puissent nous rejoindre avec le matériel qu’ils possèdent déjà, et nous voulons que le réseau continue de fonctionner quoi qu’il arrive dans une partie de la chaîne d’approvisionnement.
Il y a aussi une raison pratique liée au jeu vidéo. PlayStation et Xbox utilisent toutes deux des puces graphiques AMD, de sorte qu’une grande partie des jeux auxquels les gens jouent sont déjà conçus et réglés pour du matériel AMD.
La suite
Nous travaillons à mettre les nœuds AMD en production, sur les serveurs de tours télécoms, et sur des sessions d’IA en direct en plus des jeux. Si vous avez un PC équipé d’un GPU AMD, suivez notre Discord et ce blog : nous annoncerons quand les nœuds AMD pourront rejoindre le réseau.
GPU NVIDIA et AMD, même réseau. Plus de façons de nous rejoindre, moins de points de défaillance uniques.
à propos de YOM
YOM exploite l’edge de session GPU : des GPU à côté de chaque utilisateur, payés à la session. Des PC de jeu appartenant à leurs hôtes, et des baies télécoms proches des utilisateurs, font tourner le streaming de jeux (YOM Games, et Walter sur walter.gg pour les joueurs) et des conversations IA en direct (YOM AI). Une session Standard d’une durée maximale d’une heure coûte US$0.08 ; une heure de jeu sur un GPU de centre de données réservé coûte US$1.23. Latence médiane aller simple, mesurée en direct sur les 30 derniers jours : 20 ms pour les joueurs à moins de 50 km d’un nœud, 37.1 ms sur l’ensemble des sessions (yom.net/source-of-truth).
à lire aussi
articles similaires
le réseau sous tout cela
le travail en temps réel doit se faire tout près
À une cinquantaine de kilomètres de la personne qui l’attend. Le matériel aussi proche des gens existe déjà, et il est en grande partie éteint.